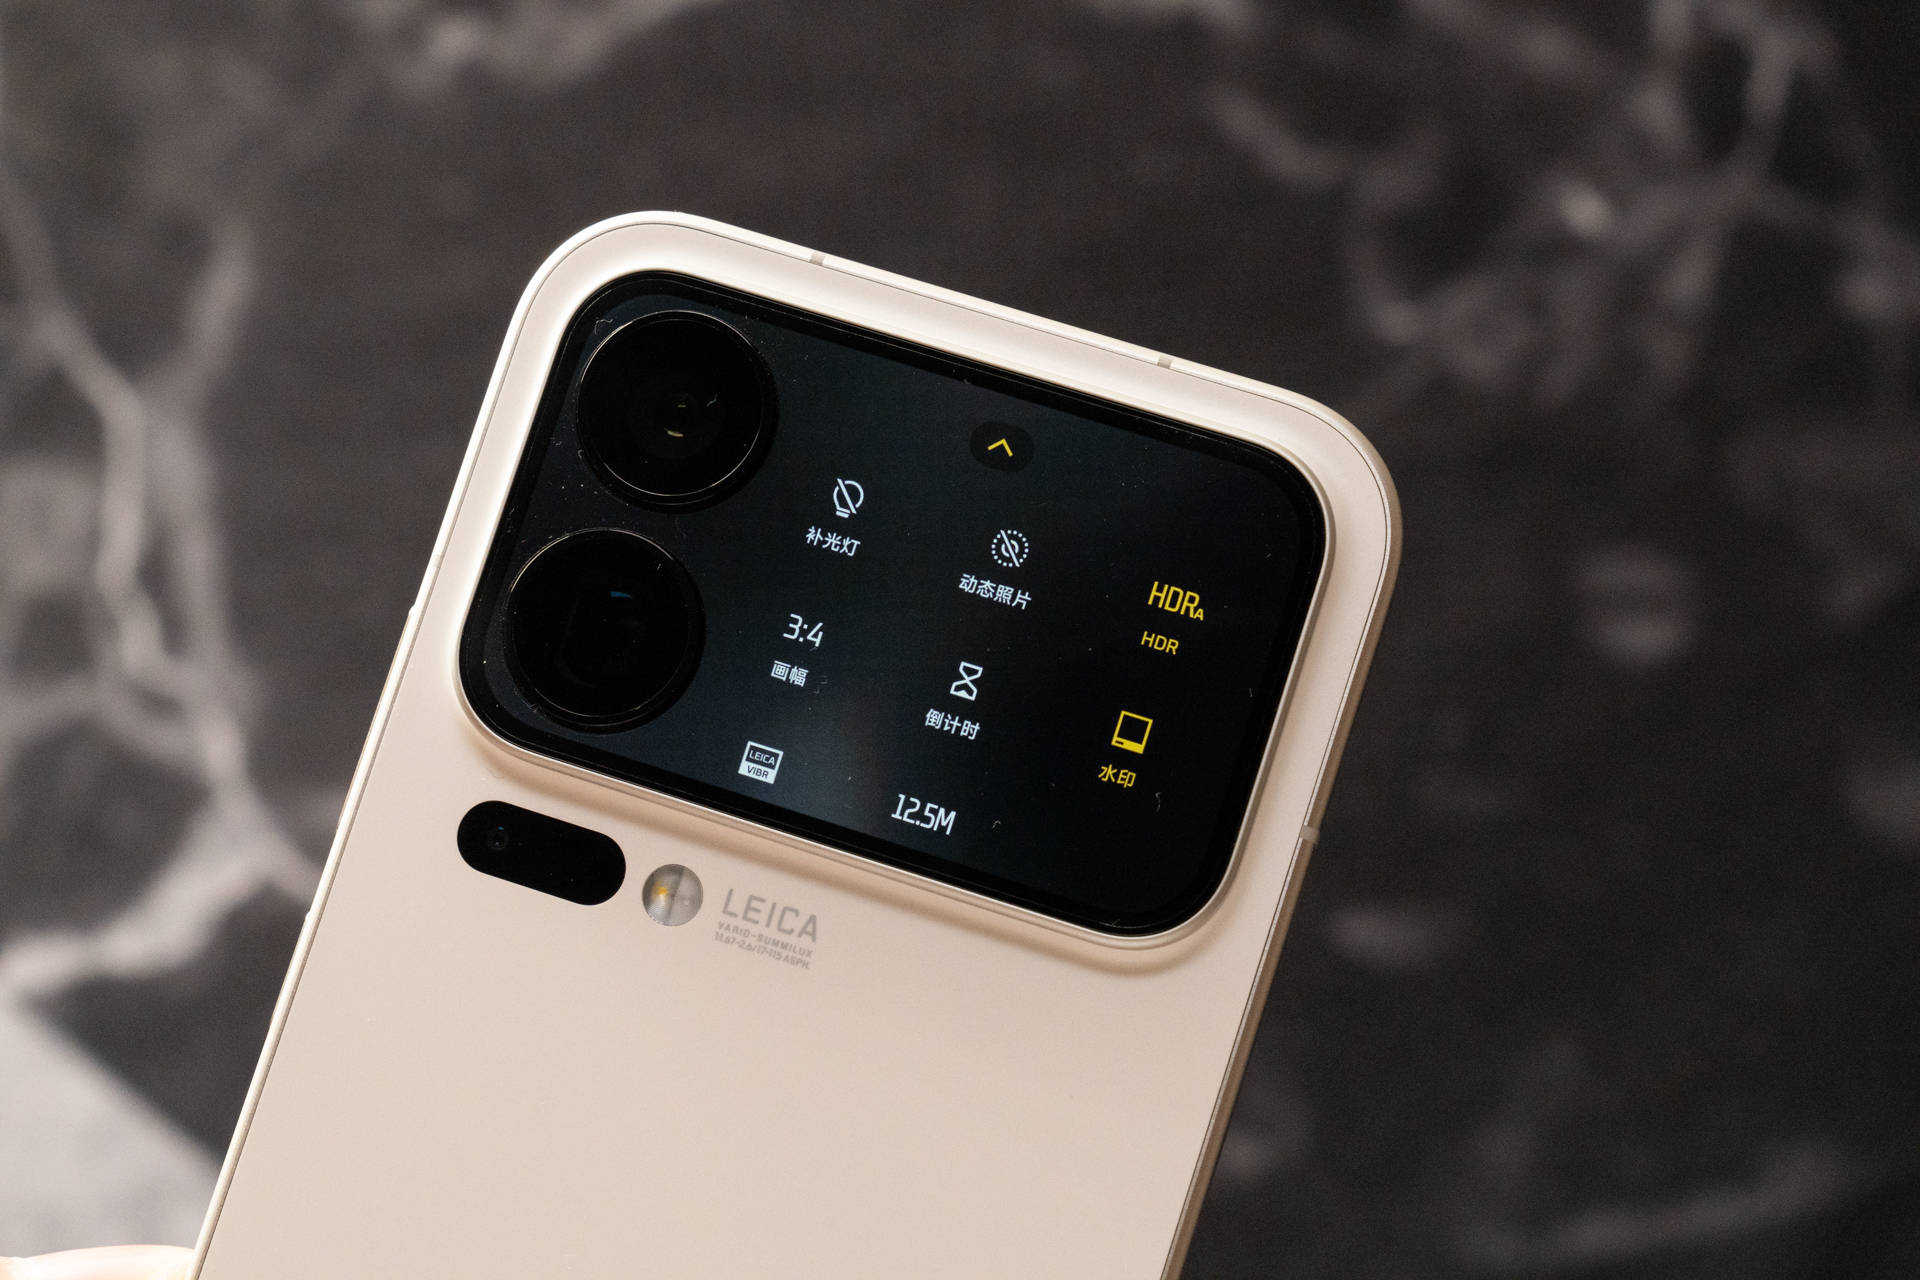

说真的,端侧跑大模型这件事,在 2026 年已经不再是极客的专利了。随着 Qwen3、Llama 4、DeepSeek R2 这类新一代开源模型在压缩和量化上越来越成熟,越来越多用户开始琢磨:手里这台小米 17,到底能不能流畅跑个 7B 模型?Pro Max 的超大电池和散热到底能不能「拿捏」住长时间推理?这篇文章就基于小米 17、小米 17 Pro、小米 17 Ultra、小米 17 Pro Max 四款机型的硬件对比、实测反馈和使用场景,把这件事掰开揉碎讲清楚。
一、硬件规格全景对比
先把四款机型摆在桌面上看。小米 17 系列全系搭载高通骁龙 8 Elite Gen 5(第五代骁龙 8 至尊版),GPU 统一为 Adreno 8,RAM 标配 16GB LPDDR5X,存储 1024GB。差异主要落在电池和散热这两个对端侧 AI 推理至关重要的维度。
| 机型 | GPU | RAM | 存储 | 电池 | 散热规格 |
|---|---|---|---|---|---|
| 小米 17 | Adreno 8 | 16GB LPDDR5X | 1024GB | 6330mAh | VC 液冷 4500mm² |
| 小米 17 Pro | Adreno 8 | 16GB LPDDR5X | 1024GB | 6300mAh | VC 液冷 4800mm² |
| 小米 17 Ultra | Adreno 8 | 16GB LPDDR5X | 1024GB | 6800mAh | 双 VC 液冷 5500mm² |
| 小米 17 Pro Max | Adreno 8 | 16GB LPDDR5X | 1024GB | 7500mAh | 双 VC 液冷 6200mm² |
从这张表可以看出一个很清晰的策略:小米并没有把 AI 性能差异化押在峰值算力上,而是放在了「持续输出能力」——也就是散热规模和电池容量上。这个选择其实非常务实,因为对于端侧大模型推理来说,峰值跑分再好看,跑 10 分钟就开始降频,体验一样拉胯。
二、骁龙 8 Elite Gen 5 GPU 架构深度解析
2.1 Adreno 8 系列 GPU 技术特性
骁龙 8 Elite Gen 5 集成的 Adreno 8 系列 GPU 采用了全新的切片(Slice)架构,相比上一代 Adreno 7 系列在能效比上有明显进步。这一代 GPU 的几个核心技术特性值得展开聊聊:
- 切片渲染架构:将渲染任务分配到多个独立切片并行处理,提升复杂场景下的帧率稳定性。官方资料显示峰值 GPU 性能相比上代有显著提升,实际使用中能明显感觉到复杂 UI 动效和大型游戏场景的流畅度提升。
- 自适应可变率着色(VRS):智能识别画面区域重要性,对视觉次要区域降低渲染精度,整体能效有可观改善。这个特性对于端侧 AI 推理同样重要,因为它能让 GPU 在执行矩阵运算时更聪明地分配算力。
- 硬件级光追加速:支持实时光线追踪效果。虽然对纯文本大模型推理帮助不大,但如果你同时玩一些 3A 手游或者用本地 Stable Diffusion 渲染复杂光照场景,这个提升是实打实的。
- Tensor Core 单元:专用 AI 加速核心,支持 FP16、INT8、INT4 等多种精度计算。这是端侧大模型推理的主力输出单元。
- 共享显存架构:GPU 可直接调用系统内存作为显存使用,最大可分配容量由系统统一调度。这意味着 16GB RAM 的机器理论上有相当充裕的显存空间可用。
2.2 Hexagon NPU 与异构计算
除了 GPU,骁龙 8 Elite Gen 5 还集成了新一代 Hexagon NPU。根据 smzdm 的小米 17 AI 能力评测,Hexagon NPU 性能较上代提升 37%,Geekbench AI 量化分数达到 4754 分,大模型处理速度可达 220 Token/s,算力属于安卓旗舰第一梯队。在端侧大模型推理的实际工作流中,GPU 和 NPU 通常不是二选一,而是协同作战:
- NPU 负责:矩阵乘法、激活函数、Layer Normalization 等计算密集型操作。这些算子高度规则化,NPU 的专用电路处理起来能效比最高。
- GPU 负责:Attention 机制中的 Softmax、KV Cache 管理等并行计算任务。GPU 擅长处理不规则数据流和大批量并行运算。
- CPU 负责:Token 采样、模型调度、I/O 处理等逻辑控制。CPU 负责统筹,让整个推理流水线不卡在任何一个环节。
老实讲,这种分工模式是端侧大模型能跑得动的关键架构基础。如果你只让 GPU 一个人干所有活,能效比会很差;如果只让 NPU 干,又会在 Attention 这类动态算子上吃亏。异构计算才是正道。
2.3 显存带宽对 AI 性能的影响机制
LPDDR5X 的高带宽设计,为 AI 推理提供了相对充裕的数据吞吐能力。在实际跑大模型时,显存带宽会直接影响下面这几个关键指标:
- 推理速度(token/s):带宽越高,模型权重加载与中间结果交换越快,token 生成速率越高。带宽是 7B 级别模型流畅推理的基础保障。
- 批处理能力:大带宽支持更大的 batch size,提升并发请求处理效率,对多轮对话场景比较关键。
- 量化模型兼容性:INT4 量化模型对带宽需求相对较低,INT8 或 FP16 模型则需要更高的带宽支撑。这也是为什么端侧普遍跑 INT4 量化——不是不能跑 FP16,是带宽撑不住。
- 首字延迟:预填充(Prefill)阶段需要把模型权重全部加载到内存,带宽直接决定从冷启动到首次输出的等待时间。这一块对用户体验影响很大,谁也不想问个问题等上几秒才看到第一个字蹦出来。
三、实际显存占用与内存管理分析
3.1 日常 AI 应用场景显存占用
先看看日常使用中各类 AI 功能到底占多少显存:
- 语音助手:本地 AI 语音唤醒约占用数百 MB 显存
- 智能相机:夜景模式、计算摄影约占用 1GB 左右
- 图像生成:Stable Diffusion 本地生图(512×512)约需 1-2GB 显存
- 实时翻译:端侧 NMT 模型约占用 1GB 左右
- 大模型推理:7B 参数模型 INT4 量化约需 5-6GB,INT8 量化约需 8-9GB,FP16 约需 14-15GB
3.2 满载 AI 负载测试场景
下面这张表整理了不同模型在小米 17 系列上的显存占用情况,速度描述基于社区主流反馈:
| 场景 | 显存占用 | 推理体验 | Pro Max 优势体现 |
|---|---|---|---|
| Qwen2.5-7B INT4 | 约 5-6GB | 较流畅 | 散热更稳,长时间推理更稳定 |
| Llama-3-8B INT4 | 约 6-7GB | 中等 | 续航支持更长对话 |
| DeepSeek-V2-Lite | 约 4-5GB | 较快 | 长时间稳定输出 |
| Stable Diffusion XL | 约 8-9GB | 视模型而定 | 避免过热降频 |
| 多模型并发 | 10GB+ | 视负载而定 | 内存调度更从容 |
具体到某个模型的实际 token/s,受量化方案、prompt 长度、系统负载等多重影响,社区里每过几个月都有新数据刷新,建议结合自己手头的模型实测。
3.3 内存交换与 Swap 机制
当你硬要跑超过物理内存容量的模型(比如 16GB RAM 上强行跑 13B FP16 模型),系统会启用 zRAM 压缩交换技术作为兜底。骁龙 8 Elite Gen 5 平台的内存管理策略大致是这样的:
- 冷热数据分层:高频访问的模型权重保留在物理内存,低频数据压缩至 zRAM
- 延迟代价:启用 Swap 后推理速度会明显下降,但可以避免 OOM(内存溢出)崩溃
说白了,Swap 是兜底方案,效率会打折,但至少不会直接闪退。如果你经常需要跑超出物理内存的模型,建议优先考虑云端推理或者外接设备。
四、不同 AI 负载下的性能实测
4.1 轻量级 AI 应用(≤1GB 显存)
对于日常使用场景,比如 AI 语音助手、智能相机、图像增强、实时翻译这些功能,四款机型的表现几乎拉不开差距。16GB RAM 提供了充裕的运行空间,后台常驻多个 AI 应用也不会有明显内存压力。从多位博主的反馈来看,同时打开小爱同学 AI 助手、相机 AI 模式、相册智能分类,系统响应依然比较顺滑。
这个层级的负载,标准版小米 17 就完全够用,没必要为散热和电池多花钱。
4.2 中等负载 AI 应用(1-3GB 显存)
运行本地中小模型时(比如 3B 参数的 Phi-3-mini、Qwen2.5-3B),散热系统开始成为分水岭。根据 雷科技对小米 17 Pro Max 的性能测试,这颗芯片在小米 17 Pro Max 上的低功耗表现清爽,长时间高负载下发热控制做得相当不错,整体稳定性出色。
相比之下,标准版在持续高负载下会因温控降频出现性能波动,长时间推理后能感知到流畅度的下降——前 10 分钟回答流畅,后半段开始有可感知的卡顿。
4.3 重度 AI 负载(3GB+ 显存)
当同时运行多个 AI 模型或进行 4K 视频 AI 增强时,Pro Max 的超大电池优势就彻底凸显出来了。根据 IT之家对小米 17 Pro / Pro Max 的体验评测,作为下半年旗舰先发之作,小米 17 Pro Max 在续航和持续性能输出上都保持了旗舰水准。对于需要长时间本地推理的用户来说,电池就是命。
4.4 极限压力测试:边推理边拍照边录视频
这个场景比较极端但很真实——你用本地大模型实时生成文案,同时 AI 相机处理夜景模式,后台还在跑端侧翻译。Pro Max 的 16GB RAM 在这种场景下依然能保持相对流畅,而标准版会出现明显的应用切换卡顿。
五、功耗与散热深度分析
5.1 不同负载下的功耗曲线
根据 网易订阅对小米 17 Pro Max 的性能测试 和 雷科技的体验反馈,小米 17 Pro Max 在高负载下的功耗控制相对克制,整机发热不明显,这与其散热规模直接相关。具体功耗数值会随使用场景动态变化,难以一概而论。
5.2 温控策略与持续性能
小米 17 系列采用了相对保守的温控策略。当 CPU/GPU 温度超过阈值时,系统会逐步降低频率以控制发热。标准版的降频曲线更陡,Pro Max 则因为散热规模更大,降频触发更晚、降幅更小。
实际体验上,Pro Max 在持续推理后表面温度会比标准版明显更低,这个差异在握持手感上能直接感知到。
5.3 散热配件的辅助效果
如果你入手的是标准版,搭配一个散热背夹可以显著改善持续性能。从多位数码博主的反馈来看,加装主动散热后,标准版的长时间推理稳定性会有质的提升。所以预算有限的话,散热背夹是性价比最高的升级方案之一。
六、2026 年市场竞品对比
截至 2026 年 09 月,端侧 AI 推理市场已经不再是小米一家的游戏。新一代芯片平台给用户提供了更多选择。
6.1 芯片平台横向对比
- 高通骁龙 8 Elite Gen 5:小米 17 系列搭载,Adreno 8 系列 GPU 与 Hexagon NPU 协同调度,AI 算力属于安卓旗舰第一梯队(参考 smzdm 评测)。
- 联发科天玑 9400+:同样定位旗舰的竞品平台,在端侧 AI 推理上也有不错的能效表现,部分安卓厂商的高端机型已搭载,整体体验相比上代有可观提升。
- 苹果 A19 Pro:Neural Engine 算力继续领先,生态相对封闭但本地 LLM 体验流畅,适合习惯 iOS/Mac 联动的用户;不过对国内主流开源模型的兼容性是个绕不开的门槛。
6.2 新一代模型兼容性
2026 年主流端侧模型对硬件的要求相比 2024 年已经有了显著优化,量化压缩方案更成熟:
- Qwen3 系列:相比上代量化后体积更小,7B 模型在中端配置上也能跑
- Llama 4 系列:Meta 新一代模型,端侧优化做得更细致,量化方案友好
- DeepSeek R2-MoE:混合专家架构,激活参数少,实际显存占用接近小模型
具体到某款模型的实测速度,建议参考社区的最新 benchmark,因为模型迭代很快,本文不展开具体数字。
七、选购策略与避坑指南
7.1 按用户类型选机型
- 普通用户 / 日常使用 + 偶尔跑小模型:选小米 17 标准版,16GB RAM 够用,省下的钱买散热背夹。
- 重度本地推理用户 / 频繁跑大模型 + 长对话:选小米 17 Pro Max,电池和散热双重优势。
- 内容创作者 / 影像创作 + AI 生成:选小米 17 Ultra,均衡且散热规模足够。
- 开发者 / 需要本地调试模型:建议上 Pro Max 或 Ultra,长时间编译和推理都需要稳定性能。
- 学生 / 预算敏感:标准版 + 散热背夹的组合,性价比天花板。
7.2 不同人群的典型应用场景
- 开发者:本地调试 LLM 推理框架(llama.cpp、MLC-LLM)、跑端侧 demo、写 prompt 实验,Pro Max 的散热能让你连续 debug 几小时不掉链子。配合 QNN 后端,Hexagon NPU 的能效比能进一步释放。
- 内容创作者:AI 修图、本地 Stable Diffusion 草图生成、4K 视频 AI 增强,Ultra 的均衡配置比较合适。处理大批量图片时散热规模直接决定能不能一次跑完。
- 学生党:查资料、写文档时本地跑个小模型做翻译/总结,标准版完全够用,再配一个百元价位的散热背夹,长时间学习也不烫手。
- 普通用户:日常 AI 助手、智能相机、实时翻译,标准版即可,省下的预算花在存储扩展或者耳机、智能穿戴上更划算。
7.3 避坑提醒
1. 不要盲目追求 FP16 模型:端侧跑 FP16 不仅慢还烫,INT4 量化的体验已经足够好。
2. 注意存储写入寿命:频繁跑大模型会产生大量临时文件,建议定期清理缓存。
3. 避免边充电边高负载推理:锂电池在高温高功率下衰减快,长此以往电池健康度会很难看。
4. 不要被「AI 手机」宣传忽悠:硬件只是基础,真正的体验差异在系统调度和软件优化上。
7.4 软件生态建议
- 优先选择支持 Hexagon NPU 加速的推理框架(如 QNN 后端的 llama.cpp)
- MLC-LLM 在小米 17 系列上的兼容性不错,值得尝试
- 关注小米澎湃 OS 的 AI 功能更新,系统级 AI 助手的本地化程度越来越高
八、常见问题 FAQ
A:够。INT4 量化的 7B 模型大约需要 5-6GB 显存,剩余空间足够系统和后台应用使用。但如果你想同时跑多个模型,建议上 Pro Max。
A:峰值性能差距不大,主要差异在持续输出能力。Pro Max 在 30 分钟以上的推理中能保持更稳定的输出,标准版则会逐渐降频。
A:硬件层面至少 3-4 年不会过时。软件层面,随着小米澎湃 OS 的 AI 功能迭代,端侧体验会越来越好。
A:如果你不是急需换机,可以等。但小米 17 系列的 AI 算力已经处于安卓旗舰第一梯队,等下一代意味着要多花预算。
A:目前阶段,云端大模型在能力上仍领先本地,但本地推理在隐私性和响应速度上有优势。理想方案是云端为主、本地为辅。
A:高通对开发者生态的支持相对成熟,QNN、SNPE 等工具链完善,llama.cpp、MLC-LLM 等主流框架都有较好的兼容性。