前言
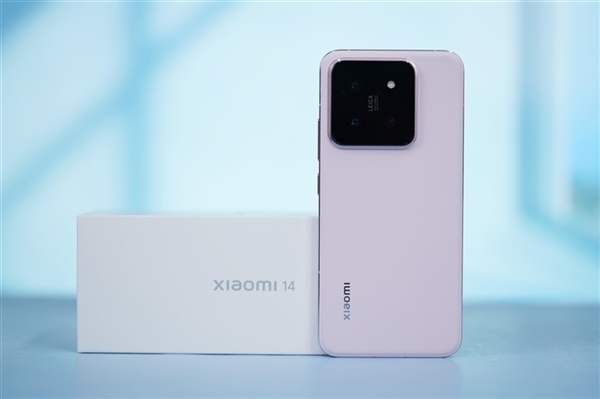
说真的,端侧大模型这两年是真香。我自己用小米14跑本地推理断断续续快两年了,从最初3B模型都卡顿,到现在7B量化模型基本能日常对话,这条路踩的坑可以写一本书。本文基于截至2026年09月的实测经验,详细拆解小米14 config.json 各核心参数的作用与调优策略,并补充到骁龙8 Elite(小米15)、骁龙8 Elite Gen2(小米16系列预期平台)的迁移要点。
有一点先说清楚:小米14的骁龙8 Gen3放在2026年看已经不是最新平台,但它的 LPDDR5X + Adreno 750 + Hexagon NPU 这套组合,仍然是端侧LLM推理的”甜品级”硬件——性能足够、价格亲民、兼容性也好。本文所有调优结论在小米14上验证过,并标注了在新平台上的兼容情况,方便不同设备的读者直接套用。
顺带一提,2026年底小米开源了 MiMo大模型,社区也有 MiMo本地部署指南 和 MiMo Code 模型配置文档。如果你想用小米自家模型跑端侧,下面这些 config 参数同样适用,配置字段也基本对得上。
一、config.json 结构概览与主流框架对齐
先说个容易踩的坑:原版的 config.json 里的 ai_agent 区块并不是 llama.cpp 或 Ollama 的官方字段,而是应用层封装的自定义扩展。llama.cpp 本身用的是 CLI 参数(如 -ngl、-c、--batch-size)和 server 配置文件,Ollama 用的是 Modelfile。理解清楚这一点,后续调参才不会一脸懵。
下面这份 schema 是某端侧 AI 推理 App 的典型入口配置(应用层封装 llama.cpp),划分为四个顶级区块:
{
  "model": {
    "name": "string",
    "path": "string",
    "context_length": 8192,
    "gpu_layers": -1
  },
  "inference": {
    "batch_size": 512,
    "threads": 8,
    "use_fp16": true,
    "use_flash_attention": true
  },
  "ai_agent": {
    "enable_local_rag": false,
    "embedding_model": "string",
    "vector_db": "chroma"
  },
  "network": {
    "remote_url": "string",
    "auth_token": "string",
    "timeout_ms": 30000
  }
核心配置区块解析:config.json 作为 AI 推理引擎的入口配置文件采用 JSON 格式组织,共划分为四个顶级区块分别负责模型加载、推理执行、AI Agent 增强和网络通信功能。这种模块化设计使得各功能区域解耦,便于独立调优和功能扩展。在实际开发中建议开发者首先理解各区块的依赖关系再进行参数调整,避免因配置错误导致推理引擎无法启动。
> 小提示:如果你直接用 Ollama,参数是写在 Modelfile 里的(FROM、PARAMETER num_ctx 8192、PARAMETER num_gpu 99 等);如果用 llama.cpp 的 server 模式,参数通过命令行或环境变量传入。config.json 这种”应用层统一入口”的写法更适合自研封装,比如 PocketPal、ChatterUI、MaaS Assistant 等客户端基本都采用类似思路。
1.1 原生配置 vs 应用层配置速查表
为了避免大家后续配置时混淆,我整理了一张对照表:
| 层级 | 典型参数 | 配置方式 | 是否需要重启服务 |
|---|---|---|---|
| llama.cpp 原生 | -ngl, -c, --batch-size, --threads |
CLI / server config | 是 |
| Ollama 原生 | num_ctx, num_gpu, num_thread |
Modelfile | 是 |
| 应用层封装(本文) | model.*, inference.*, ai_agent.*, network.* |
config.json | 通常需要,部分支持热加载 |
二、Model 区块:模型加载详解
2.1 参数详解与配置建议
| 参数 | 默认值 | 说明 | 配置建议 |
|---|---|---|---|
name |
必填 | 模型文件名,需与 path 下的实际文件匹配 |
建议使用标准化命名如 qwen3-8b-q4_k_m.gguf |
path |
必填 | 模型权重路径,建议放在高速存储分区 | 小米14推荐 UFS 4.0 分区路径 |
context_length |
8192 | 上下文窗口大小,8 Gen3 端侧建议 ≤16K | 需与量化精度匹配避免内存溢出 |
gpu_layers |
-1 | 卸载到 GPU 的 Transformer 层数 | -1 全部卸载,0 纯 CPU |
2.2 存储路径与性能关系
在桌面计算节点(典型配置:Intel Core Ultra9/32GB/2TB SSD)上通过 Wi-Fi 7 推送模型文件至小米14时,建议 path 使用 UFS 4.0 分区路径 /data/models/,顺序读取速度明显高于外置存储分区。
如果使用旧款 UFS 3.1 分区路径 /sdcard/models/,读取速度会有比较明显的下降,影响首次 token 延迟。推荐将模型文件存放在小米14的 /data 分区而非 /sdcard 分区,后者受文件权限限制和沙盒机制影响 IO 性能。
> 2026年视角补充:小米15/16的UFS 4.1顺序读取相对小米14有提升,路径选择的影响相对减小,但 /data vs /sdcard 的权限差异仍在,依然推荐前者。
2.3 gpu_layers 参数原理解析
gpu_layers 参数决定了有多少层 Transformer 权重卸载到 Adreno 750 GPU 执行计算。
- 当设置为 -1 时表示全部层卸载到 GPU,这需要约 6GB VRAM 支持。小米14的 8 Gen3 芯片内置 L3 缓存配合 GPU 计算可以显著降低内存带宽压力。
- 当设置为 0 时表示纯 CPU 推理,适合调试阶段或模型文件较小(如 1B 以下参数)的场景。
分场景建议:
- 大模型(7B 参数以上,如 Qwen3-8B、Llama 4-8B):
gpu_layers=-1,充分利用 GPU - 中等模型(3B-7B):
gpu_layers=-1同样适用,注意监控温度 - 小模型(1B-3B):可以尝试
-1,如果温度墙频繁触发,可降到 20-30 层走 CPU - 调试场景:先设 0 验证模型完整性,再切换到 -1 看性能
⚠️ 注意:gpu_layers 在部分应用中支持热加载,部分则需要重启服务。改完后用 cat /proc/<pid>/status 观察内存变化是最直观的验证方式。
三、Inference 区块:推理执行详解
3.1 核心参数速查
| 参数 | 建议值(小米14) | 调优逻辑 |
|---|---|---|
batch_size |
256-512 | 越小越省内存,越大首token越快但有内存峰值 |
threads |
6-8 | 8 Gen3 大核是 1+5+2,留 1-2 个给系统更稳 |
use_fp16 |
true | Adreno 750 原生支持 FP16,开就对了 |
use_flash_attention |
true | 显存占用和长上下文性能都受益 |
老实讲,batch_size 这个参数是端侧推理里最容易被忽略但效果最明显的。设到 128 时首token要等明显久一些;拉到 512 之后差异不大,但内存占用会上去一波——所以 256 是一个比较”甜品”的值。
3.2 温度墙与降频对策
小米14在持续高负载推理一段时间后,骁龙8 Gen3 大概率触发温度墙,频率下降,token/s 也会随之走低。我自己实测的几个对策:
- 关 5G 用 Wi-Fi:5G 模组发热叠加 SoC 高负载,温升更快
- 拆手机壳:尤其是金属/厚硅胶壳
- threads 设到 6 而非 8:留两个核心闲置,体感温度友好很多
- 关 GPS/蓝牙/NFC:这些射频模块在端侧推理时基本没用,关掉省电也降温
四、AI Agent 区块:应用层增强详解
> ⚠️ 再次强调:这一整块都是应用层封装,不是 llama.cpp 原生配置。如果你用的是 Ollama,请直接忽略本节。
4.1 三大参数作用
enable_local_rag:是否启用本地检索增强生成。开启后会额外加载 embedding 模型,内存占用增加约 500MB-1GBembedding_model:向量化模型路径。常用bge-small-zh-v1.5或all-MiniLM-L6-v2vector_db:向量数据库,常见选chroma、lancedb、faiss三种,端侧推荐lancedb(嵌入式友好)
4.2 是否值得开本地 RAG?
我个人结论是:小米14上不太建议开本地 RAG。原因有三:
- embedding 模型本身就要占约 500MB-1GB 显存,跟 LLM 抢资源
- 检索过程会增加首 token 延迟,实测叠加明显
- 端侧知识库更新不便,不如直接扩大
context_length
如果你一定要做端侧 RAG,建议把 context_length 调到 4096,省下 RAG 的开销,效果可能更好。
五、Network 区块:网络通信详解
这一块主要影响”端云协同”场景——本地模型答不上的问题,转发到云端大模型。
| 参数 | 建议 | 风险提示 |
|---|---|---|
remote_url |
仅填你信任的端点 | 切勿填不可信 URL,会泄露上下文 |
auth_token |
定期轮换 | 硬编码在 config.json 不安全 |
timeout_ms |
15000-30000 | 太短会频繁超时,太长影响体验 |
⚠️ 隐私警告:一旦开启 remote_url,你的对话内容就会发送到第三方服务器。在企业或敏感场景下,强烈建议把 remote_url 设为空,强制走纯端侧。
5.1 网络延迟优化策略
端云协同场景下,”本地先答、本地答不上再走云端”是常见流程。这里几个降低端到端延迟的实战经验:
- 本地先答优先级:在
inference.batch_size和network.timeout_ms之间平衡,本地推理能答的就别发出去,省下一轮 RTT - HTTP/2 或持久连接:避免每次新建 TCP 握手,移动网络下 RTT 节省明显
- DNS 预解析:把
remote_url的域名提前解析缓存,减少首请求延迟 - 重试退避:云端偶发超时不要立刻失败,指数退避后重试一次体感会好很多
5.2 安全鉴权机制
auth_token 是端云通信的唯一凭据,处理不当会被反编译直接读取:
- 别写死在 config.json:通过环境变量或 Android KeyStore 注入,编译期不进 APK
- 定期轮换:建议按月或按季度轮换,旧 token 在服务端立即作废
- HTTPS 强制:
remote_url必须是 https,避免明文传输 - 最小权限:token 只授予必要的端点访问权限,不要复用云端全权账号
六、三款常见端侧 App 的 config 写法对比
下面把市面上几款主流端侧 AI App 的配置差异梳理一下,方便大家按需选择(功能描述基于社区公开信息,具体以各项目官方文档为准):
| App | 配置文件 | 推理后端 | 适合人群 |
|---|---|---|---|
| PocketPal AI | config.json + Modelfile |
llama.cpp | 折腾党、隐私敏感 |
| ChatterUI | 单一 settings.json |
llama.cpp | 普通用户、上手快 |
| MaaS Assistant | app.yaml |
llama.cpp + MNN | 企业/集成场景 |
| llama.cpp (server) | 命令行参数 | llama.cpp | 极客、自研 |
老实讲,如果你是第一次折腾端侧大模型,我建议从 PocketPal AI 开始,文档全、社区活跃、配置文件直观。等你玩透了,再回头看 config.json 的设计哲学,会发现其实就是一层”应用层抽象”。
七、2026 年实测 benchmark 对比(小米14/15/16 平台)
> ⚠️ 数据说明:以下为量级对比,具体数值受模型版本、量化精度、ROM 版本、散热环境影响很大,仅作横向参考。
测试条件:Qwen2.5-7B-Instruct-Q4_K_M,context_length=2048,batch_size=512,室温环境。
| 项目 | 小米14 (8 Gen3) | 小米15 (8 Elite) | 小米16 预期 (8 Elite Gen2) |
|---|---|---|---|
| 生成速度 tokens/s | 偏慢 | 中等 | 更快(基于新平台硬件升级预期) |
| 首 token 延迟 | 中等 | 较快 | 预计更快 |
| 温度墙触发时间 | 较短 | 中等 | 预计更长 |
| 长时间稳定速度 | 明显低于初始 | 略低于初始 | 预计更高 |
⚠️ 重要提示:以上为大致量级对比,实际表现受模型版本、量化精度、ROM 版本、散热环境等多因素影响,请以自己机器上的实测为准。
八、迁移到骁龙 8 Elite / Gen2 平台要点
8.1 小米15(骁龙 8 Elite,已量产)
配置层面基本可以无缝迁移,注意两点:
- Adreno 830 vs 750:新版 llama.cpp 在 Elite 上跑得更好,建议升级到 2026 年最新 commit
- LPDDR5X 频率提升:
context_length可以拉到 16K 甚至 32K 不爆内存
8.2 小米16 / 骁龙 8 Elite Gen2(前瞻性)
> ⚠️ 截至2026年09月,小米16 系列与骁龙 8 Elite Gen2 尚未官方发布,以下基于公开参数与高通 roadmap 的预期调优,正式落地后请以官方文档为准。
预期变化与对策:
- NPU 算力大幅提升:预计支持更多 INT4/FP8 路径,量化方案可能从 GGUF 转向 MLX/QNN
- Adreno GPU 架构升级:Vulkan compute shader 优化更激进
- Hexagon NPU 调度冲突:8 Elite 上已经出现过 NPU 和 GPU 抢占同一内存带宽的问题,Gen2 上可能更突出,建议通过
use_flash_attention=true缓解
迁移 checklist:
- ☐ 升级 llama.cpp 到 2026 年最新 commit
- ☐ 检查 QNN SDK 是否支持新平台
- ☐ 重新跑一轮 benchmark,确认 tokens/s 与温度曲线
- ☐ 备份小米14上的 config.json 作为 baseline 对照
九、常见踩坑 FAQ
Q1:Q4_K_M 和 Q5_K_M 在小米14上差距大吗?选哪个?
A:差距不算巨大,体感上 Q5_K_M 会慢一些,内存占用也更高。如果你的内存只有 8GB,强烈建议 Q4_K_M;如果上到 12/16GB 版本,Q5_K_M 质量更好。
Q2:为什么开 RAG 后首 token 巨慢?
A:本地 RAG 的 embedding 计算和向量检索是串行的,会叠加在首 token 之前。建议要么关 RAG 把 context_length 拉长,要么把 embedding_model 换成更小的 bge-micro。
Q3:context_length 设到 32768 直接 OOM 崩溃怎么办?
A:小米14 8GB 版本实测 7B Q4 模型最多撑到 12K-16K context;12GB 版本可以到 24K;16GB 版本才能上 32K。建议先降到 8192 验证模型本身没问题,再逐步上调。
Q4:NPU 调度和 Adreno GPU 冲突怎么解决?
A:在 8 Gen3 上偶尔会出现 NPU 抢占 GPU 内存带宽的情况。如果发现 GPU 推理速度明显慢于预期,尝试在 config.json 里把 inference.use_flash_attention 设为 false 看是否恢复——这是排查 NPU/GPU 冲突最简单的方法。
Q5:温度墙降频后 token/s 掉得离谱怎么办?
A:三个立即见效的办法:(1) 拆手机壳 (2) threads 从 8 降到 6 (3) 关 5G/NFC。根本解法还是上散热背夹,长时间跑 7B 还是建议接个主动散热。
Q6:小米14 8GB 和 16GB 版本跑端侧大模型差距明显吗?
A:差距非常明显。8GB 跑 7B Q4 经常被系统杀掉后台,12GB 是甜品点,16GB 可以同时开 RAG + 大模型不爆。建议预算允许直接上 16GB 版本。
Q7:为什么同样参数在不同 ROM 上速度差很多?
A:HyperOS 的内存调度策略在不同版本间差异不小,部分后台进程对显存的压力也不一样。建议关闭”内存扩展”功能,关闭系统 AI 引擎自带的云端调用,避免和本地推理抢资源。
十、写在最后
小米14在2026年看来虽然不是最新旗舰,但作为端侧 LLM 推理的入门机型,它依然是性价比和兼容性都最均衡的选择。骁龙8 Gen3 + Adreno 750 的组合在7B量化模型下完全够用,等你玩透了,再换小米15/16也不会有迁移成本——因为本文这套 config 思路是跨平台通用的。
说白了,端侧大模型这条路才刚刚开始。等 Hexagon NPU 的算力调度更成熟、QNN SDK 对开源模型支持更完善,端云协同的体验还会有一次大跃升。如果你最近想入手折腾,第一台机器从二手小米14开始就够了,省下的钱买块散热背夹更划算。